Qwen Image Edit 2511 線画を着色まとめ
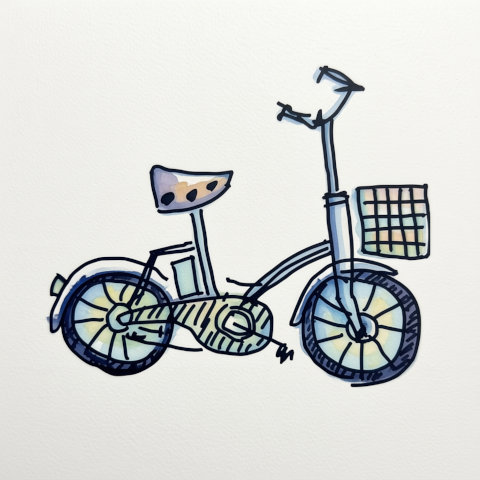
ちまたでは Qwen Image 2.1がオープンウェイト版が出たみたいですが、 ここでは Qwen Image Edit 2511 の話です。
昨年末に Qwen Image Edit 2511 が出た以降、Qwen Image 系はクローズドになってしまい、まあそうだよね、という感じではある。 ここにきて再びオープンウェイトが突然出たけど、商用利用はできないし。 大金かけてつくったモデルなので、提供者側に(無料提供したことで)メリットがないかぎり継続されないのは仕方ないのであろう。
Apple なども macOS Golden Gate (version 27) で、fm コマンド導入とかローカルで使える AI を強化してきたし、 Googlebook もおそらく ローカル AIとして Gemini が使えるようになるのではないかと期待。 Local で使う AI はモデル提供者のメリットがあるOSと抱き合わせ方式が今後主流になっていくのではないかな。 これなら(みかけ上の)無料提供も提供者側のメリットあるから継続的に提供されていく可能性は高い。
そもそも、いくら(高価なGPUや Macをもっていることを前提として)無料で高性能な Local AI が使えるといっても ユーザー各々が何ギガもあるファイルをローカルに入れて動かすというのは(一般コンシューマ向けには)無理がある。
Antrhopic とかも、今度は「人類滅亡」とか言い出したし。 一年くらい前には、AIが仕事を奪うとか、その前はプログラマー不要になるとかなんとか。
Gemini に聞いた
AI業界の「悲観論・脅威論」のトレンドは、短期間で目まぐるしくゴールポストが動いてきました。時系列で振り返ると、おおむね次のような展開を辿っています。
2022年末〜2023年前半:「プログラマー不要論」 ChatGPT(GPT-3.5/4)やGitHub Copilotが脚光を浴びた時期です。「コードが自動生成できるならエンジニアは要らなくなる」「コーディング教育はオワコン」といった過激な言説が飛び交いました。
実際はどうだったか: コード作成の初速は圧倒的に上がりましたが、アーキテクチャ設計、複雑なドメイン知識の落とし込み、デバッグ、コードレビューの負担が増加。「AIが書いたコードの辻褄を合わせる人間」が依然として不可欠という現実に落ち着いています。
2023年〜2024年:「ホワイトカラーの仕事激変論」 ターゲットがプログラマーだけでなく、ライター、イラストレーター、翻訳者、カスタマーサポートなどオフィスワーク全般に広がったフェーズです。「あと数年で多くの職種が淘汰される」「AIに仕事を奪われる前に使いこなせ」という煽り文句が全盛を極めました。
実際はどうだったか: 確かに業務効率化のツールとして不可欠にはなったものの、ハルシネーション(嘘の出力)問題、セキュリティや著作権のリスク、最終責任を誰が取るかという壁があり、「人間のチェック(Human-in-the-loop)」を外せない運用が大半です。
2023年中盤〜現在:「人類存亡リスク(X-Risk)・滅亡論」 AnthropicやOpenAIの経営陣、あるいは著名なAI研究者たちが「AIの暴走による人類滅亡リスク」を公の場で真剣に論じるようになったフェーズです。「核兵器やパンデミックと同等の世界的リスクとして扱うべき」という声明が出たり、Anthropicが生物兵器作成やサイバー攻撃への悪用、自律的な制御不能シナリオを懸念して安全基準(RSP)を更新したりしています。
背景にあるもの: 実際の現場での「使い勝手の限界(泥臭い泥沼作業)」とは裏腹に、モデルが超大型化・汎用化(AGI化)した先にある最悪のシナリオ(アライメント失敗や自律暴走)を議論するフェーズに入ったためです。また、自社の技術力の高さをアピールする裏返し(「滅亡させるほど強力なものを作っている」)や、法規制を主導するためのロビー活動という側面を指摘する冷めた見方もあります。
AIが生物兵器の開発や核ミサイルの運用管理に使われることになれば人類滅亡も十分あり得る話になるのでしょうけれど。 さらに言えば、たいていの未来予想はハズレるし、事前に予見できるようなことであれば防がれるのがほとんどなので、 本当に人類滅亡するような何かをAIが引き起こすとしたら、ほとんどの人が予想してなかったような・・・ブラックスワン的なことが原因になりそうではある。
コーディング用途やあれやこれやの相談、ググるの代用としての AI としては Opus 5 で十分すぎるので、人類滅亡するかもしれない開発は停止して、 ローカルPC GPU 16GB VRAM くらいで動かせる Opus 5 くらいの性能のモデル開発に(Anthropic がそれやることは絶対ないので・・・だれか)注力してほしい。 AIのせいで人類滅亡するくらいだったら、なおのこと。
本題 Qwen Image Edit 2511
今までバラバラに書いてきたので一回まとめます。
環境: RTX 3060 (VRAM 12GB) + メモリ 32GB の Ubuntu 24.04 Server , CPU は Ryzen 5500
ドライバを入れる:
sudo apt update
sudo apt install -y ubuntu-drivers-common
sudo ubuntu-drivers devices
これを薦められた:
driver : nvidia-driver-595-open - distro non-free recommended
のだが、現在使用しているマシンはサーバーなので、結局これを入れた:
sudo apt install -y nvidia-driver-595-server-open
ちなみにこのマシンでは secure boot はOFFにしています。
このコマンドで確認:
$ mokutil --sb-state
SecureBoot disabled
Platform is in Setup Mode
これでリブートしたらもう使えます。
次のコマンドで確認:
$ nvidia-smi
Mon Sep 21 10:21:28 2026
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 595.91.07              Driver Version: 595.91.07      CUDA Version: 13.2     |
...
画像を着色するスクリプト
img2img.py
import gc
import random

import argparse
from dataclasses import dataclass

import torch
from PIL import Image
from diffusers import (
    GGUFQuantizationConfig,
    QwenImageTransformer2DModel,
    QwenImageEditPlusPipeline
)
from transformers import (
    BitsAndBytesConfig as TFBitsAndBytesConfig,
    Qwen2_5_VLForConditionalGeneration
)

import re
from pathlib import Path

from huggingface_hub import hf_hub_download


_HF_URL_RE = re.compile(
    r"^https://huggingface\.co/(?P<repo_id>[^/]+/[^/]+)/(?:blob|resolve)/(?P<revision>[^/]+)/(?P<filename>.+)$"
)

def resolve_ckpt_path(ckpt_path: str) -> str:
    """ローカルパスならそのまま、Hugging Face の URL ならダウンロード(キャッシュ)してパスを返す。"""
    m = _HF_URL_RE.match(ckpt_path)
    if m is None:
        if not Path(ckpt_path).exists():
            raise FileNotFoundError(f"checkpoint not found: {ckpt_path}")
        return ckpt_path
    return hf_hub_download(
        repo_id=m["repo_id"],
        filename=m["filename"],
        revision=m["revision"],
    )

def create_transformer(
    model_id: str,
    ckpt_path: str,
    dtype: torch.dtype,
) -> QwenImageTransformer2DModel:
    return QwenImageTransformer2DModel.from_single_file(
        resolve_ckpt_path(ckpt_path),
        quantization_config=GGUFQuantizationConfig(compute_dtype=dtype),
        torch_dtype=dtype,
        config=model_id,
        subfolder="transformer",
    )

def create_pipe(
    model_id: str,
    deviceCUDA: torch.device,
    dtype: torch.dtype,
) -> QwenImageEditPlusPipeline:
    tf_quant_config = TFBitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=dtype,
    )

    text_encoder = Qwen2_5_VLForConditionalGeneration.from_pretrained(
        model_id,
        subfolder="text_encoder",
        quantization_config=tf_quant_config,
        torch_dtype=dtype,
        device_map={"": deviceCUDA},   # 読み込み時に直接 GPU に載せる
    )

    # transformer なしでパイプラインを組み、先にエンコードだけ済ませる
    pipe = QwenImageEditPlusPipeline.from_pretrained(
        model_id,
        transformer=None,          # まだ載せない
        text_encoder=text_encoder,
        torch_dtype=dtype,
    ).to(deviceCUDA)

    return pipe

def precompute_embeds(
    pipe: QwenImageEditPlusPipeline,
    deviceCUDA: torch.device,
    prompt: str,
) -> tuple[torch.Tensor, torch.Tensor]:
    with torch.no_grad():
        prompt_embeds, prompt_embeds_mask = pipe.encode_prompt(
            prompt=prompt,
            device=deviceCUDA,
        )
    return prompt_embeds, prompt_embeds_mask

def swap_to_transformer(
    pipe: QwenImageEditPlusPipeline,
    deviceCUDA: torch.device,
    deviceCPU: torch.device,
    transformer: QwenImageTransformer2DModel,
) -> QwenImageEditPlusPipeline:
    # text_encoder をGPUから完全に追い出す
    pipe.text_encoder.to(deviceCPU)
    del pipe.text_encoder
    gc.collect()

    torch.cuda.empty_cache()

    pipe.transformer = transformer

    pipe.load_lora_weights(
        "lightx2v/Qwen-Image-Edit-2511-Lightning",
        weight_name="Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16.safetensors"
    )

    pipe.enable_group_offload(
        onload_device=deviceCUDA,
        offload_device=deviceCPU,
        offload_type="leaf_level",
        use_stream=True,
    )

    pipe.vae.enable_tiling()
    pipe.vae.enable_slicing()
    return pipe


MODEL_ID = "Qwen/Qwen-Image-Edit-2511"
CKPT_PATH = "https://huggingface.co/unsloth/Qwen-Image-Edit-2511-GGUF/blob/main/qwen-image-edit-2511-Q2_K.gguf"

#
# よりシンプルな着色
#
SYSTEM_PROMPT = """Color this hand-drawn line sketch with Copic alcohol markers on smooth bleedproof marker paper.

Keep every original line exactly where it is. The lines stay hand-drawn and slightly uneven, just cleaned up and a bit darker. Do not redraw, straighten, or add anything that was not in the sketch.

Alcohol Marker coloring: translucent ink that lets the paper show through, visible streaks where strokes overlap, colors darkening where layers cross, soft feathered gradients instead of flat fills, a little bleeding past the outlines. Fresh light colors, casual and a bit imperfect.

Ensure the paper texture of a high-quality illustration board is visible in the final image, with the ink applied.

The sketch sits on a plain sheet of drawing paper with even blank margins of bare paper on all four sides."""

NEGATIVE_SYSTEM_PROMPT = "signature, artist signature, autograph, handwriting, text, letters, words, characters, kanji, katakana, watermark, logo, monogram, initials, stamp, seal, hanko, copyright notice, date, caption, title, label, credit, scribble in corner, writing on paper, border decoration"


def colorize(
    pipe: QwenImageEditPlusPipeline,
    deviceCUDA: torch.device,
    image: Image.Image,
    seed: int,
    prompt_embeds: torch.Tensor,
    prompt_embeds_mask: torch.Tensor | None,
    negative_system_prompt: str | None,
) -> Image.Image:
    image = image.convert("RGB").resize((512, 512))

    torch.cuda.empty_cache()

    result = pipe(
        image=[image],
        prompt_embeds=prompt_embeds,
        prompt_embeds_mask=prompt_embeds_mask,
        negative_prompt=negative_system_prompt,
        true_cfg_scale=1.0,
        num_inference_steps=4,
        generator=torch.Generator(device=deviceCUDA).manual_seed(int(seed)),
    )

    return result.images[0]


def main():
    parser = argparse.ArgumentParser(description="Qwen-Image-Edit CLI")

    parser.add_argument(
        "--input",
        required=True,
        help="input image file path",
    )
    parser.add_argument(
        "--output",
        required=True,
        help="output image file path",
    )
    parser.add_argument(
        "--seed",
        type=int,
        default=None,
        help="random seed (省略時はランダムに生成)",
    )
    parser.add_argument(
        "--model",
        default=CKPT_PATH,
        help="GGUF model file path",
    )
    args = parser.parse_args()

    seed = args.seed if args.seed is not None else random.randint(0, 999999)
    print(f"from {args.input} to {args.output}")
    print(f"seed: {seed} を使います")
    print(f"model: {args.model}")

    ckpt_path = args.model
    input_image_file_path = args.input
    output_image_file_path = args.output

    print("モデルを読み込んでいます... (初回は数分かかることがあります)")

    deviceCUDA = torch.device("cuda")
    deviceCPU  = torch.device("cpu")
    dtype      = torch.bfloat16

    transformer = create_transformer(MODEL_ID, ckpt_path, dtype)
    pipe = create_pipe(MODEL_ID, deviceCUDA, dtype)
    prompt_embeds, prompt_embeds_mask = precompute_embeds(pipe, deviceCUDA, SYSTEM_PROMPT)
    pipe = swap_to_transformer(pipe, deviceCUDA, deviceCPU, transformer)

    print("モデルの読み込みが完了しました")

    image = Image.open(input_image_file_path).convert("RGB")

    output_image = colorize(
        pipe,
        deviceCUDA,
        image,
        seed,
        prompt_embeds,
        prompt_embeds_mask,
        NEGATIVE_SYSTEM_PROMPT
    )
    output_image.save(output_image_file_path)

if __name__ == "__main__":
    main()
実行方法
実行時にGGUFのモデルを指定しなければ、コード中で設定されているモデルをダウンロードします:
CKPT_PATH = "https://huggingface.co/unsloth/Qwen-Image-Edit-2511-GGUF/blob/main/qwen-image-edit-2511-Q2_K.gguf"
その場合は次のように実行:
python img2img.py --input input.png --output output.png
input.png は着色するための画像です。各自で用意してください。
もしすでにローカルに GGUF ファイルをダウンロード済みならば:
python img2img.py --input input.png --output output.png --model /path/to/qwen-image-edit-2511-Q2_K.gguf
seed 値を固定したければ --seed 42 のようにコマンドライン引数として指定可能です。
実行結果 Q2 .. Q6 まで試した:
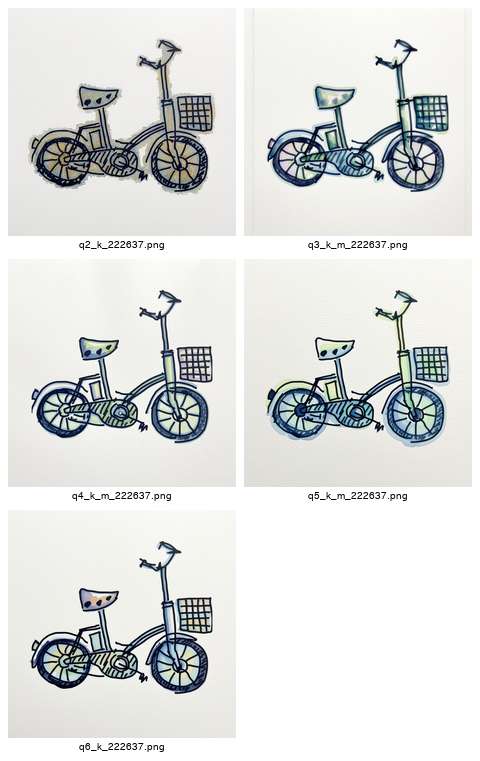
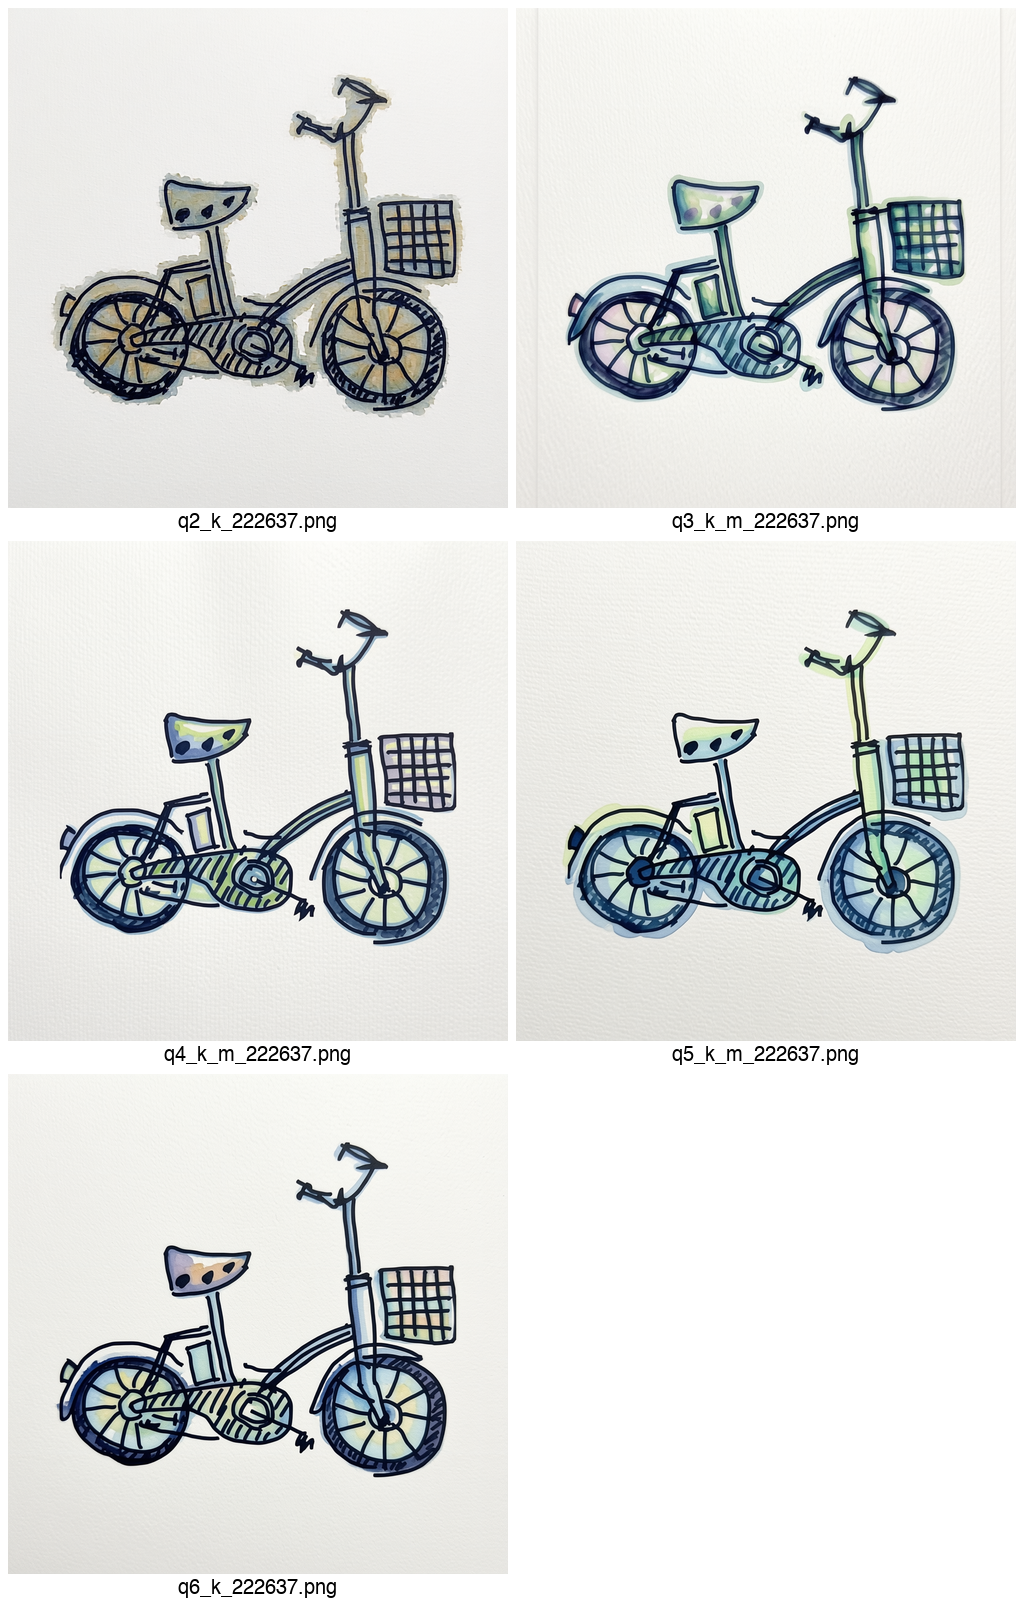
なお、seed は 222637 を指定しています。
補足
Q6_K(qwen-image-edit-2511-Q6_K.gguf) までは 12GB VRAM でも動かすことができました。 Q8(qwen-image-edit-2511-Q8_0.gguf) も試しましたが、これは無理でした。
以前試したときは RTX 3060 12GB では Q2_K 程度が実用ラインだと思っていたのですが、 コードを工夫する(といっても Claude に教えてもらっただけですが)などして、 Q6_K を使うことができました。 あくまで体感ですが、 Q2_K の生成速度と比べても Q6_K はそこまでの遅さは感じません。 以前は CPU が Ryzen 2400G のマシンを使用していたので、もしかするとそのあたりも生成速度に影響していたかも。